

Привіт:) noindex — одна з найважливіших директив для технічної SEO-оптимізації сайту на WordPress. Вона дозволяє повідомити пошуковим системам, що конкретну сторінку, тип контенту або інший ресурс не потрібно показувати в результатах пошуку.
На практиці noindex використовують для внутрішніх сторінок пошуку, технічних сторінок, окремих архівів, малокорисних сторінок, службових URL, деяких сторінок WooCommerce та інших елементів сайту, які не мають самостійної пошукової цінності.
Але важливо розуміти: noindex — це не універсальний інструмент для "покращення SEO". Безсистемне закриття сторінок від індексації може позбавити сайт органічного трафіку, якщо під noindex потраплять корисні категорії, посадкові сторінки, товари або статті.
-
🧭 Що таке
noindex -
🎯 Навіщо потрібен
noindexу WordPress -
🧩 Як працює
noindex -
📌
Noindex,nofollowтаindex, follow: у чому різниця -
noindex, follow - 🚫 Noindex ≠ robots.txt
-
noindex -
robots.txt -
⚙️ Як поставити
noindexу WordPress -
🔧 Як зробити
noindexу WordPress через SEO-плагін -
📄 Як поставити
noindexна окрему сторінку -
🗂️
Noindexдля категорій WordPress -
Коли категорію можна розглядати для
noindex -
🏷️
Noindexдля тегів WordPress - Практичне правило
-
👤
Noindexдля архівів автора -
📅
Noindexдля архівів дат -
🔎
Noindexдля внутрішнього пошуку WordPress -
🛒
Noindexу WooCommerce - Що зазвичай не повинно індексуватися
- Що може потребувати індексації
-
🧠
Noindexдля сторінки подяки -
🔐 Чи потрібно ставити
noindexна сторінки входу та адміністративні URL -
🧱 Як додати
noindexу WordPress без SEO-плагіна -
🧑💻
Noindexдля конкретної сторінки через PHP -
⚠️ Чому не варто хаотично редагувати
functions.php -
🌐
X-Robots-Tag: noindexдля PDF та інших файлів - 📊 Які сторінки WordPress індексувати, а які — ні
-
🧮
Noindexі "краул-бюджет" -
🔗
Noindexі внутрішня перелінковка -
🧷
Noindexіcanonical— це не одне й те саме -
Canonical -
Noindex -
🗑️
Noindexчи видалити сторінку? - Приклад
-
🧹
Noindexпорожніх категорій і тегів -
📱 Чи потрібно ставити
noindexна мобільні сторінки - 🧪 Як перевірити noindex у WordPress
- Спосіб 1. Перегляд HTML
- Спосіб 2. Google Search Console
- Спосіб 3. Перевірка HTTP-заголовків
-
🔬 Як переконатися, що
noindexсправді працює -
⚠️ Типові помилки при використанні
noindex - 1. Закривати всі категорії
- 2. Закривати всі теги без аналізу
-
3. Використовувати
robots.txtзамістьnoindex -
4. Додавати
nofollowавтоматично - 5. Ставити noindex на важливі сторінки
- 6. Забувати про WooCommerce
- 7. Дублювати правила з кількох SEO-плагінів
- 8. Перевіряти тільки налаштування WordPress
-
🚨 Чи можна випадково видалити сайт із Google через
noindex? - Особливо важливо після:
-
🧰
Noindexна staging-сайті - 📋 Практичний аудит noindex для WordPress
-
📊 Якою має бути правильна стратегія
noindex - 🟢 Група 1 — Index
-
🟡 Група 2 —
Noindex -
🔴 Група 3 — Не
noindex, а інше рішення -
🧭
Noindexі XML Sitemap -
🧠 Чи передає
noindexпосилальну вагу -
🧩
Noindexдля custom post types -
🧱
Noindexдля кастомних таксономій -
🧪 Чеклист перед встановленням
noindex -
🔍 Як знайти сторінки, які помилково отримали
noindex -
🔄 Що відбувається після видалення
noindex -
🛠️ WordPress
noindex: оптимальна схема роботи - Крок 1. Зробіть карту URL
- Крок 2. Розділіть URL за роллю
- Крок 3. Налаштуйте SEO-плагін
-
Крок 4. Залиште можливість ручного
noindex -
Крок 5. Перевірте
robots.txt - Крок 6. Перевірте sitemap
- Крок 7. Перевірте Search Console
- 🏁 Висновок
-
❓ FAQ: поширені запитання про
noindexу WordPress -
Що таке
noindexу WordPress? -
Чи впливає
noindexна ранжування сторінки? -
Чим
noindexвідрізняється відnofollow? -
Чи потрібно ставити
noindex, nofollow? - Чи потрібно закривати категорії WordPress від індексації?
-
Чи потрібно ставити
noindexна теги WordPress? -
Чи потрібно ставити
noindexна сторінку подяки? -
Чи потрібно ставити
noindexна сторінку пошуку WordPress? -
Чи можна використовувати
robots.txtзамістьnoindex? -
Чи можна одночасно використовувати
robots.txtіnoindex? -
Чи можна поставити
noindexбез SEO-плагіна? -
Як поставити
noindexна PDF? -
Чи робить
noindexсторінку приватною? -
Чи потрібно видаляти
noindexзі всіх сторінок? -
Чи може
noindexнашкодити SEO? -
Як перевірити, чи сторінка має
noindex? -
Чи потрібно додавати
noindexу XML sitemap? -
Що краще:
noindexчи301 redirect? -
Чи потрібно ставити
noindexна архіви авторів? -
Чи потрібно ставити
noindexна архіви дат? -
Що робити, якщо важлива сторінка випадково отримала
noindex? -
Чи є
noindexфактором ранжування?
У цьому матеріалі розберу:
- як побудувати логічну стратегію індексації сайту.
- що таке
noindex; - як він працює у Google;
- чим
noindexвідрізняється відnofollow; - чим
noindexвідрізняється відrobots.txt; - як налаштувати
noindexу WordPress; - як закривати від індексації окремі сторінки;
- чи потрібно ставити
noindexна категорії та теги; - що робити з архівами авторів і дат;
- як налаштувати
noindexдля WooCommerce; - як реалізувати
noindexбез SEO-плагіна; - як використовувати
wp_robots; - як перевірити, чи справді сторінка має
noindex; - які типові помилки допускають власники WordPress-сайтів;
- коли
noindexвикористовувати не потрібно; - як побудувати логічну стратегію індексації сайту.
🧭 Що таке noindex
Noindex — це директива для пошукових роботів, яка повідомляє пошуковій системі, що певну сторінку або ресурс не потрібно включати до пошукового індексу.
Для HTML-сторінки найпоширеніший варіант виглядає так:
<meta name="robots" content="noindex">А якщо потрібно одночасно заборонити індексацію сторінки та не рекомендувати пошуковому роботу переходити за посиланнями на ній:
<meta name="robots" content="noindex, nofollow">Google описує noindex як правило, яке забороняє показувати сторінку, медіафайл або інший ресурс у результатах пошуку. При цьому сторінка може залишатися доступною для користувачів за прямим URL або через внутрішні посилання.
Це принципова відмінність:
noindexне видаляє сторінку з сайту. Він керує її присутністю у пошуковому індексі.
Наприклад, якщо на сайті є сторінка:
https://example.com/thank-you/і для неї встановлено:
<meta name="robots" content="noindex">користувач, який має URL, як і раніше може відкрити сторінку. Але Google отримує інструкцію не показувати її у звичайній пошуковій видачі.
🎯 Навіщо потрібен noindex у WordPress
WordPress автоматично створює велику кількість різних типів URL:
- записи;
- сторінки;
- категорії;
- теги;
- архіви авторів;
- архіви дат;
- сторінки пошуку;
- сторінки пагінації;
- архіви користувацьких таксономій;
- сторінки товарів;
- категорії товарів WooCommerce;
- теги товарів;
- службові сторінки;
- результати фільтрації;
- сторінки кошика;
- checkout;
- особистий кабінет;
- сторінки подяки;
- технічні URL.
Не кожен із цих URL повинен отримувати органічний трафік.
Наприклад, сторінка внутрішнього пошуку:
/?s=wordpressможе бути корисною для відвідувача, але зазвичай не є самостійною SEO-посадковою сторінкою.
Так само сторінка:
/thank-you/після відправлення форми навряд чи повинна потрапляти до Google.
У таких ситуаціях noindex дозволяє розділити:
URL, потрібні користувачам → залишаються доступнимиі
URL, які не мають самостійної пошукової цінності → не потрапляють до індексу.WordPress має власну систему wp_robots, яка використовується для формування robots-директив у HTML. Наприклад, WordPress має штатну функцію для додавання noindex, а для внутрішніх сторінок пошуку передбачений відповідний механізм.
🧩 Як працює noindex
Спрощено процес можна представити так:
Користувач відкриває URL → Googlebot отримує сторінку → Google бачить robots directive → визначає, чи можна додавати сторінку до індексу → якщо присутній noindex, сторінка не повинна показуватися в Google SearchВажливий момент: пошуковий робот повинен мати можливість отримати сторінку та прочитати директиву noindex.
Google прямо зазначає, що robots meta tags та X-Robots-Tag можуть бути прочитані й виконані лише тоді, коли Googlebot має доступ до сторінки. Якщо URL одночасно закритий від сканування через robots.txt, Google може не побачити noindex.
Тому конструкція:
robots.txt → Disallow: /private-page/
HTML → noindex
не є правильним способом гарантовано повідомити Google про noindex.
Якщо Google не може просканувати сторінку, він не обов'язково зможе прочитати її noindex.
📌 Noindex, nofollow та index, follow: у чому різниця
Ці директиви часто плутають.
| Директива | Індексація сторінки | Переходи за посиланнями |
|---|---|---|
index, follow | Так | Так |
noindex, follow | Ні | Так |
index, nofollow | Так | Не рекомендується переходити |
noindex, nofollow | Ні | Не рекомендується переходити |
Найважливіша для SEO-команди комбінація:
noindex, follow
Вона означає:
Не показуй цю сторінку в результатах пошуку, але посилання на ній можуть залишатися доступними для обходу.
Саме тому не потрібно автоматично додавати nofollow кожного разу, коли ви використовуєте noindex.
Google окремо визначає noindex та nofollow як різні правила: перше стосується появи сторінки у результатах пошуку, друге — переходу за посиланнями на сторінці.
🚫 Noindex ≠ robots.txt
Це одна з найважливіших відмінностей технічного SEO.
noindex
Повідомляє пошуковій системі:
Цю сторінку не потрібно показувати у результатах пошуку.
robots.txt
Повідомляє crawler:
Цей URL не потрібно сканувати.
Google прямо наголошує, що robots.txt не є механізмом видалення вебсторінки з Google Search. URL, заборонений у robots.txt, все одно може з'явитися у видачі, якщо Google дізнається про нього з інших джерел.
Приклад
Неправильна логіка:
robots.txt
Disallow: /thank-you/
Якщо ваша мета — саме заборонити індексацію сторінки, краще забезпечити доступ Googlebot до URL і додати:
<meta name="robots" content="noindex">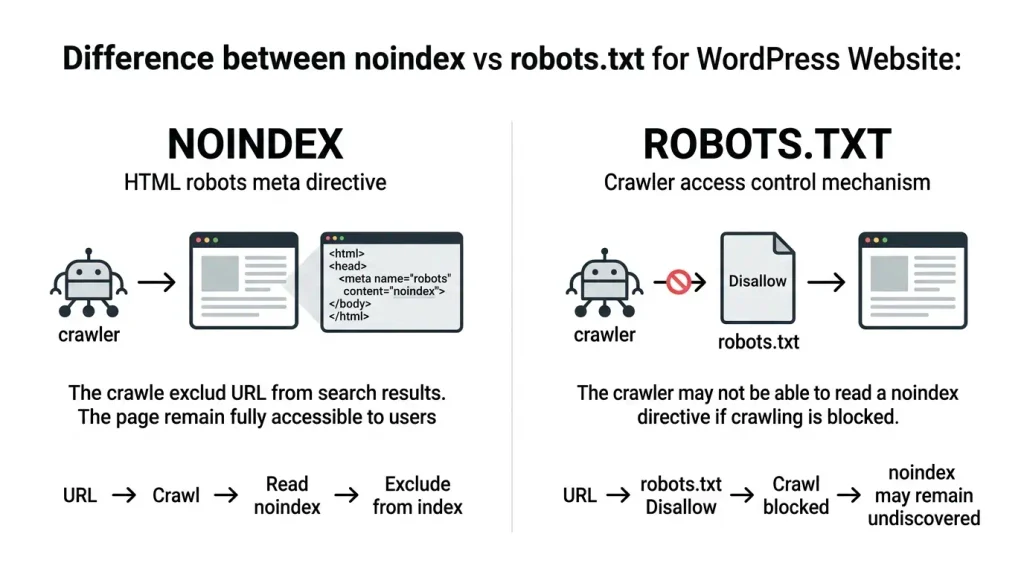
⚙️ Як поставити noindex у WordPress
Існує кілька способів додати noindex.
Основні:
- через SEO-плагін;
- через налаштування конкретного типу контенту;
- через кастомний код WordPress;
- через HTTP-заголовок
X-Robots-Tag; - через налаштування серверної інфраструктури.
Для більшості власників сайтів оптимальний варіант — SEO-плагін, оскільки він дозволяє керувати індексацією без редагування PHP або конфігурації сервера.
Для розробників і великих сайтів додатково актуальний API WordPress wp_robots.
🔧 Як зробити noindex у WordPress через SEO-плагін
Сучасні SEO-плагіни дозволяють встановлювати noindex як для окремої сторінки, так і для цілих груп URL.
Популярна логіка налаштування виглядає так:
Редагування сторінки → SEO settings → Advanced → Allow search engines to show this content → NoНаприклад, у Yoast SEO індивідуальний noindex налаштовується через Advanced-параметри сторінки. Аналогічно можна керувати індексацією типів контенту, таксономій та архівів.
Назви пунктів меню можуть відрізнятися залежно від плагіна та його версії, тому орієнтуватися краще не на точну назву кнопки, а на сам параметр:
Allow search engines to show this content in search results → No📄 Як поставити noindex на окрему сторінку
Припустимо, є сторінка:
/thank-you/або:
/special-offer-closed/і ви не хочете бачити її в органічному пошуку.
Алгоритм:
- Відкрийте сторінку в редакторі WordPress.
- Відкрийте налаштування SEO.
- Перейдіть до розширених параметрів.
- Знайдіть налаштування robots/indexing.
- Встановіть
Noindex. - Збережіть або оновіть сторінку.
- Перевірте вихідний HTML.
- За потреби перевірте URL через Google Search Console.
Очікуваний результат:
<meta name="robots" content="noindex">або еквівалентна robots-директива, сформована плагіном.
🗂️ Noindex для категорій WordPress
Категорії — значно складніший випадок.
Не існує універсального правила "всі категорії потрібно закрити від індексації".
Категорія може бути:
- корисною SEO-посадковою сторінкою;
- сторінкою з унікальним текстом;
- сторінкою з якісною структурою матеріалів;
- важливою частиною інформаційної архітектури.
У такому випадку noindex може бути помилкою.
Наприклад:
/blog/seo/може бути повноцінною тематичною посадковою сторінкою.
Якщо категорія має:
- зрозумілу тему;
- достатню кількість якісних матеріалів;
- унікальний вступний текст;
- логічний
title; - meta
description; - внутрішню перелінковку;
- реальну цінність для користувача,
її не варто закривати від індексації лише тому, що це "архів".
SEO-плагіни дозволяють окремо визначати, чи повинні категорії та інші таксономії з'являтися в пошуковій видачі. Yoast, наприклад, прямо зазначає, що корисні категорії можуть бути повноцінними landing pages.
Коли категорію можна розглядати для noindex
Наприклад, якщо вона:
- практично порожня;
- містить один запис;
- створена випадково;
- дублює іншу категорію;
- не має пошукової цінності;
- створює велику кількість слабких архівних URL.
Але перед noindex варто запитати:
Чи можна зробити цю категорію корисною?
Якщо відповідь "так", часто краще оптимізувати її, а не закривати.
🏷️ Noindex для тегів WordPress
З тегами ситуація схожа.
WordPress дозволяє створювати практично необмежену кількість tag pages:
/tag/seo//tag/wordpress//tag/google//tag/plugin//tag/test/
Якщо кожен новий запис отримує 5–10 тегів, сайт може швидко отримати сотні або тисячі архівів.
При цьому частина сторінок може бути:
- дуже короткою;
- дублювати категорії;
- містити лише один запис;
- не відповідати окремому пошуковому наміру.
У такій ситуації noindex може бути доцільним.
Але якщо тегова сторінка фактично є якісним тематичним хабом, її можна залишити індексованою.
Практичне правило
Не приймайте рішення:
"Tags = noindex."
Краще використовувати правило:
Low-value taxonomy = noindex; useful taxonomy landing page = index.
👤 Noindex для архівів автора
WordPress може створювати окремі сторінки авторів.
Наприклад:
/author/admin/На багатoавторському сайті така сторінка може бути корисною.
Вона може містити:
- ім'я автора;
- біографію;
- професійні дані;
- список публікацій;
- експертність;
- посилання на профілі.
У такому випадку author archive може бути повноцінною сторінкою.
На одновласному блозі ситуація інша: author archive часто дублює контент головної сторінки або списку записів.
SEO-плагіни дозволяють або повністю вимкнути author archives, або залишити їх доступними, але не показувати в пошуку.
Тому:
| Тип сайту | Авторські архіви |
|---|---|
| Особистий блог одного автора | Часто можна вимкнути |
| Корпоративний блог | Залежить від структури |
| Багатоавторське медіа | Часто мають SEO-цінність |
| Сайт експертів | Можуть бути важливими |
| Новинний сайт | Часто потребують окремої стратегії |
📅 Noindex для архівів дат
WordPress може генерувати:
- річні архіви;
- місячні архіви;
- денні архіви.
Наприклад:
/2026/
/2026/09/
або інші URL залежно від структури permalink.
Для багатьох сучасних сайтів такі сторінки не мають окремої пошукової цінності.
Вони можуть просто дублювати список статей, які вже доступні через категорії або інші landing pages.
Тому архіви дат часто:
- вимикають;
- редиректять;
- або залишають доступними для навігації, але виключають із пошуку.
Водночас це не означає, що будь-який date archive потрібно автоматично закривати. Для сайтів, де дата є частиною контентного наміру, архівна структура може мати іншу роль.
🔎 Noindex для внутрішнього пошуку WordPress
Сторінки внутрішнього пошуку — один із найтиповіших кандидатів на noindex.
WordPress може генерувати URL на кшталт:
/?s=wordpressабо URL із власною структурою пошуку.
Такі сторінки створюються динамічно на основі пошукового запиту користувача.
Зазвичай немає сенсу дозволяти Google індексувати нескінченну кількість комбінацій:
/?s=wordpress/?s=wordpress+seo/?s=wordpress+plugin/?s=seo+2026
WordPress має штатний механізм додавання noindex для результатів внутрішнього пошуку.
🛒 Noindex у WooCommerce
Для інтернет-магазинів стратегія індексації особливо важлива.
WooCommerce може створювати:
- сторінки товарів;
- категорії товарів;
- теги товарів;
- сторінки кошика;
- checkout;
- account pages;
- фільтрацію;
- сортування;
- параметричні URL.
Що зазвичай не повинно індексуватися
Частими кандидатами на noindex є:
- кошик;
- checkout;
- особистий кабінет;
- сторінки після оформлення;
- службові URL;
- окремі технічні результати фільтрації.
Що може потребувати індексації
Натомість потенційно цінними є:
- товарні сторінки;
- категорії товарів;
- бренди;
- колекції;
- тематичні посадкові;
- добре продумані фільтри, якщо вони відповідають реальному пошуковому попиту.
Тут особливо небезпечно використовувати глобальний noindex без аналізу.
Наприклад, URL:
/shop/laptops/може бути дуже важливою SEO-сторінкою.
А URL:
/shop/?orderby=priceможе не мати самостійної цінності.
🧠 Noindex для сторінки подяки
Сторінки типу:
/thank-you/часто використовуються після:
- відправлення форми;
- замовлення;
- реєстрації;
- завантаження матеріалу;
- підписки;
- заявки.
Вони рідко мають сенс як органічні landing pages.
Тому це один із найтиповіших випадків для:
noindex, followАле якщо сторінка використовується для важливого маркетингового сценарію, її логіку слід перевірити окремо.
🔐 Чи потрібно ставити noindex на сторінки входу та адміністративні URL
Не варто плутати:
не індексуватиі
захистити від доступу.Noindex не робить сторінку приватною.
Якщо URL містить конфіденційну інформацію, використовуйте:
- авторизацію;
- пароль;
- обмеження доступу;
- серверні механізми безпеки.
Google рекомендує використовувати password protection для справді приватного контенту. Сам noindex лише керує присутністю ресурсу в пошукових результатах.
🧱 Як додати noindex у WordPress без SEO-плагіна
WordPress має штатний wp_robots API.
Це дозволяє розробнику додавати robots directives через фільтр.
Наприклад, логіка може виглядати так:
add_filter( 'wp_robots', function( $robots ) {
    $robots['noindex'] = true;

    return $robots;
} );
WordPress документує wp_robots як фільтр для directives, що потрапляють у robots meta tag.
Такий підхід краще використовувати, коли потрібно програмно контролювати індексацію.
🧑💻 Noindex для конкретної сторінки через PHP
Наприклад, можна додати noindex для сторінки з певним ID:
add_filter( 'wp_robots', function( $robots ) {
    if ( is_page( 123 ) ) {
        $robots['noindex'] = true;
    }

    return $robots;
} );
Де 123 — ID сторінки.
Або використовувати умовні теги WordPress для більш складних сценаріїв.
Наприклад:
add_filter( 'wp_robots', function( $robots ) {
    if ( is_search() ) {
        $robots['noindex'] = true;
    }

    return $robots;
} );
WordPress уже використовує власну функцію wp_robots_no_robots() для додавання noindex, а також передбачає wp_robots_noindex_search() для пошукових сторінок.
⚠️ Чому не варто хаотично редагувати functions.php
Якщо сайт уже використовує SEO-плагін, ручне додавання robots directives може створити конфлікти.
Наприклад:
SEO-плагін → indexі одночасно:
кастомний код → noindexУ результаті потрібно розбиратися, яка саме директива формується у фінальному HTML.
Перед внесенням змін варто:
- визначити джерело поточного robots tag;
- перевірити HTML;
- перевірити SEO-плагін;
- перевірити тему;
- перевірити custom code;
- лише після цього змінювати логіку.
🌐 X-Robots-Tag: noindex для PDF та інших файлів
Для HTML-сторінок найчастіше використовується:
<meta name="robots" content="noindex">Але що робити з PDF?
PDF не має звичайного HTML <head>, тому meta robots там не підходить.
Для таких ресурсів використовується HTTP-заголовок:
X-Robots-Tag: noindexGoogle прямо рекомендує X-Robots-Tag для ресурсів, які не є HTML, зокрема PDF, відео та зображень.
Наприклад:
X-Robots-Tag: noindexможе бути застосований сервером до певного типу файлів.
📊 Які сторінки WordPress індексувати, а які — ні
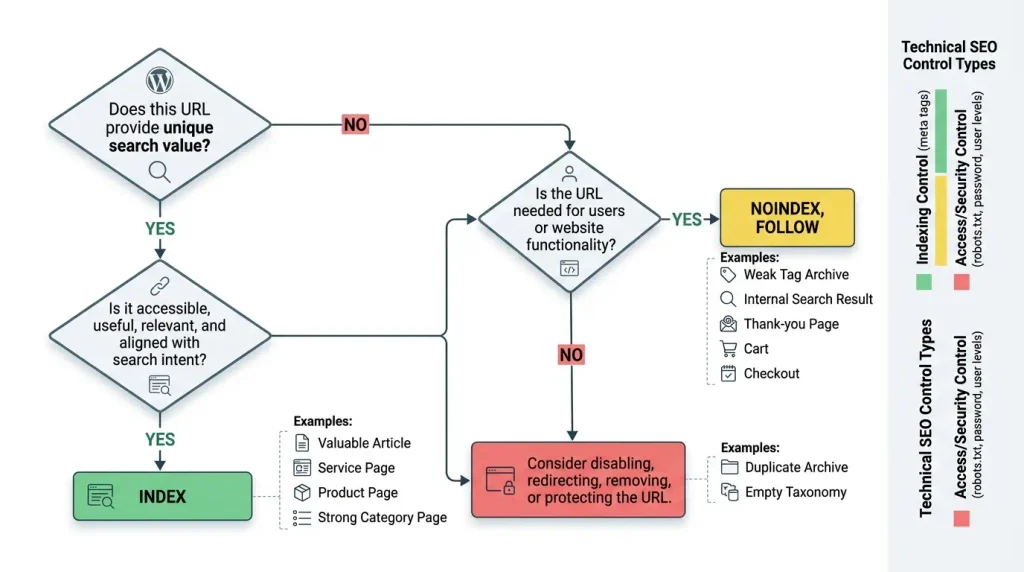
Універсальної таблиці для всіх сайтів не існує, але як стартову модель можна використовувати таку логіку:
| Тип URL | Типове рішення | Чому |
|---|---|---|
| Головна | Index | Основна сторінка |
| Корисна стаття | Index | Органічний потенціал |
| SEO-сторінка послуги | Index | Комерційний намір |
| Корисна категорія | Index | Тематичний хаб |
| Корисна сторінка товару | Index | Комерційний URL |
| Якісна категорія товарів | Index | Пошуковий попит |
| Internal search | Noindex | Динамічні результати |
| Thank-you page | Noindex | Службова сторінка |
| Cart | Noindex | Технічний сценарій |
| Checkout | Noindex | Технічний сценарій |
| Account | Noindex | Приватна зона |
| Малокорисний tag archive | Noindex | Низька цінність |
| Порожня taxonomy | Noindex | Немає контенту |
| Слабкий author archive | Noindex/disable | Низька цінність |
| Непотрібний date archive | Noindex/disable | Архів без окремої цінності |
| Корисна landing page | Index | Пошукова цінність |
| Приватний контент | Password protection | Безпека, а не SEO |
Ключове слово тут — "типове".
Рішення про noindex потрібно приймати на рівні конкретної інформаційної архітектури.
🧮 Noindex і "краул-бюджет"
Навколо noindex часто виникає міф:
"Поставимо
noindexна 1000 сторінок — і Google одразу почне краще ранжувати важливі сторінки."
Це занадто спрощене твердження.
Noindex насамперед керує індексацією та відображенням у пошуку.
Google також зазначає, що на дуже великих сайтах із сотнями тисяч URL та значною кількістю маловажливих або дубльованих сторінок контроль над crawling та індексацією може допомогти сфокусувати ресурси пошукової системи на важливішому контенті.
Але для більшості невеликих WordPress-сайтів проблема зазвичай не зводиться просто до "краул-бюджету".
Спочатку потрібно вирішити:
- які сторінки справді корисні;
- які URL дублюють один одного;
- які сторінки відповідають пошуковому наміру;
- які архіви створюють зайву URL-структуру;
- які сторінки потрібно видалити або перенаправити;
- які сторінки залишити для користувачів, але прибрати з Google.
🔗 Noindex і внутрішня перелінковка
Noindex не означає:
"На цю сторінку більше ніхто не повинен посилатися."
Сторінка може залишатися корисною для навігації.
Наприклад:
/search/може використовуватися відвідувачами сайту, хоча її не потрібно індексувати.
Тому noindex, follow може бути цілком логічним рішенням.
Так само не варто видаляти всі внутрішні посилання на noindex-сторінки механічно. Спочатку потрібно зрозуміти роль URL у користувацькому сценарії та архітектурі сайту.
🧷 Noindex і canonical — це не одне й те саме
Ще одна поширена помилка — використовувати canonical і noindex як взаємозамінні інструменти.
Canonical
Повідомляє пошуковій системі:
"Серед схожих URL вважай цей URL основним."
Noindex
Повідомляє:
"Не показуй цей URL у пошукових результатах."
Це різні задачі.
Якщо сторінка є дублем і має чіткий основний URL, canonical може бути логічнішим.
Якщо сторінка потрібна користувачам, але не повинна з'являтися в органічній видачі, noindex може бути доречнішим.
🗑️ Noindex чи видалити сторінку?
Не кожну непотрібну сторінку потрібно переводити в noindex.
Іноді правильніше:
- видалити сторінку;
- повернути
404; - повернути
410, якщо це виправдано; - налаштувати
301на релевантний URL; - об'єднати контент;
- змінити структуру сайту.
Приклад
Є дві статті:
/seo-wordpress/

/wordpress-seo-guide/
Обидві описують практично одне й те саме.
Просто поставити noindex на одну з них — не завжди найкраще рішення.
Можливо, логічніше:
- визначити основну сторінку;
- об'єднати контент;
- перенаправити старий URL;
- оновити внутрішні посилання.
Noindex — це лише один інструмент технічного SEO.
🧹 Noindex порожніх категорій і тегів
Порожні архіви — типовий кандидат для автоматичного noindex.
Наприклад:
/tag/wordpress/існує, але не містить жодного опублікованого матеріалу.
Така сторінка навряд чи має самостійну цінність.
SEO-плагіни можуть автоматично або за налаштуваннями виключати порожні taxonomy archives із пошукової індексації. Зазвичай вони мають окреме налаштування для noindex порожніх категорій і тегів.
📱 Чи потрібно ставити noindex на мобільні сторінки
Якщо WordPress використовує сучасний responsive design і одна URL-сторінка адаптується під мобільний екран, окремий mobile noindex не потрібен.
Не потрібно закривати від індексації мобільну версію лише тому, що вона має інший CSS або layout.
Важливо оцінювати URL та контент, а не сам факт відображення на мобільному пристрої.
🧪 Як перевірити noindex у WordPress
Після налаштування не варто обмежуватися тим, що галочка в SEO-плагіні встановлена.
Потрібно перевірити фактичний результат.
Спосіб 1. Перегляд HTML
Відкрийте сторінку.
Натисніть:
View Source / Переглянути код сторінкита знайдіть:
noindexВи повинні побачити robots directive.
Спосіб 2. Google Search Console
Для URL, який уже відомий Google, можна використовувати URL Inspection.
Перевірте:
- доступність URL;
- індексацію;
- robots directives;
- canonical;
- останній crawl;
- причину виключення з індексу.
Google рекомендує URL Inspection для перевірки robots meta tags та пов'язаних налаштувань.
Спосіб 3. Перевірка HTTP-заголовків
Для PDF або інших ресурсів перевірте response headers.
Потрібно шукати:
X-Robots-Tag: noindex🔬 Як переконатися, що noindex справді працює
Використовуйте такий чеклист:
- URL доступний для Googlebot;
- у HTML присутній
noindex; - немає конфліктної robots-директиви;
- сторінка не заблокована
robots.txt, якщо Google повинен прочитати noindex; - SEO-плагін не генерує іншу директиву;
- canonical не веде на несподіваний URL;
- URL не включений до XML sitemap без потреби;
- сторінка не є важливою SEO-посадковою;
- після змін перевірено URL у Search Console.
⚠️ Типові помилки при використанні noindex
1. Закривати всі категорії
Категорія може бути цінною landing page.
Проблема: втрата потенційного органічного трафіку.
2. Закривати всі теги без аналізу
Деякі tag archives справді слабкі, але не всі.
Рішення: оцінювати їхню реальну роль.
3. Використовувати robots.txt замість noindex
Google може не побачити noindex, якщо сторінка заблокована для crawl.
4. Додавати nofollow автоматично
noindex і nofollow вирішують різні задачі.
5. Ставити noindex на важливі сторінки
Найнебезпечніша помилка.
Потрібно перевіряти:
- статті;
- категорії;
- товари;
- послуги;
- комерційні landing pages.
6. Забувати про WooCommerce
Іноді noindex налаштовують для звичайних WordPress-сторінок, але залишають без контролю:
- фільтри;
- параметри;
- службові сторінки;
- taxonomy;
- дублікати.
7. Дублювати правила з кількох SEO-плагінів
Одночасне використання декількох SEO-рішень може створювати конфлікти.
8. Перевіряти тільки налаштування WordPress
Галочка в адмінці — ще не гарантія правильного фінального HTML.
Перевіряйте результат на реальному URL.
🚨 Чи можна випадково видалити сайт із Google через noindex?
Так.
Якщо встановити noindex глобально, пошуковим системам буде повідомлено не індексувати сторінки сайту.
WordPress має окреме налаштування:
Settings → Reading → Discourage search engines from indexing this siteЦей параметр генерує robots meta directive noindex, nofollow для сайту. WordPress окремо наголошує, що це не блокує доступ користувачів до сайту — це лише запит до пошукових систем.
Тому після запуску нового сайту обов'язково перевіряйте цей параметр.
Особливо важливо після:
- перенесення сайту;
- staging → production;
- зміни домену;
- міграції WordPress;
- відновлення backup;
- клонування сайту;
- створення нового середовища.
🧰 Noindex на staging-сайті
Для тестового середовища noindex може бути корисним, але для staging-сайту важливо не покладатися тільки на нього.
Якщо staging містить:
- конфіденційні дані;
- копію бази даних;
- персональну інформацію;
- приватний контент,
краще використовувати authentication/password protection.
Noindex не є механізмом безпеки.
📋 Практичний аудит noindex для WordPress
Для великого сайту зручно створити таблицю:
| URL | Тип | Пошукова цінність | Поточний статус | Рекомендація |
|---|---|---|---|---|
/blog/article-1/ | Стаття | Висока | Index | Index |
/category/seo/ | Категорія | Висока | Index | Index |
/tag/test/ | Tag | Низька | Index | Noindex |
/author/admin/ | Author | Низька | Index | Noindex/disable |
/?s=seo | Search | Низька | Index | Noindex |
/thank-you/ | Службова | Низька | Index | Noindex |
/cart/ | WooCommerce | Низька | Index | Noindex |
/checkout/ | WooCommerce | Низька | Index | Noindex |
/shop/laptops/ | Категорія | Висока | Index | Index |
Це дозволяє приймати рішення не на основі типу URL, а на основі його функції та SEO-цінності.
📊 Якою має бути правильна стратегія noindex
Хороша стратегія виглядає не так:
"Які сторінки WordPress можна закрити?"
Краще поставити питання:
"Які URL повинні брати участь у пошуковій видачі, а які потрібні лише для роботи сайту або навігації?"
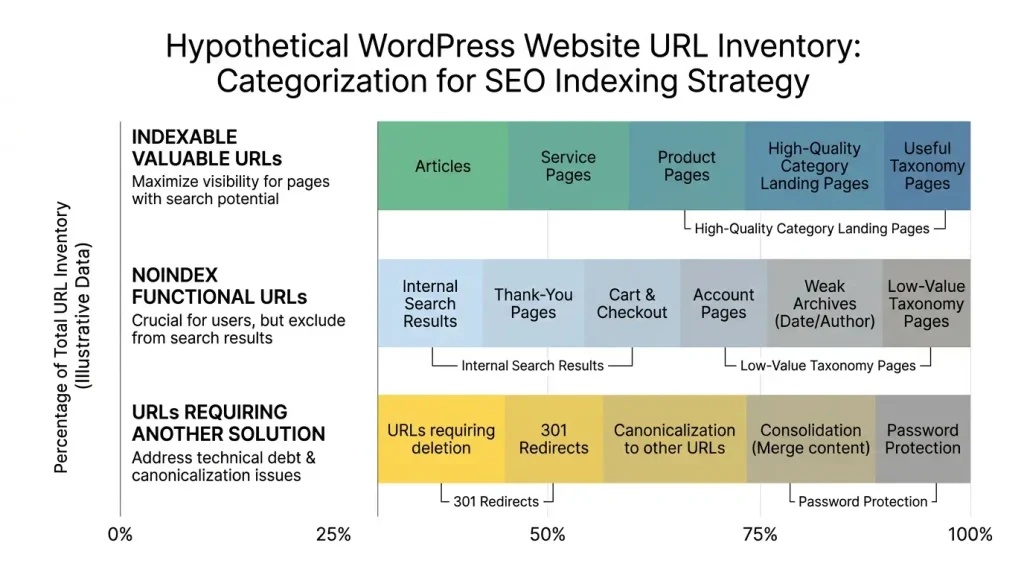
Тоді можна побудувати три групи.
🟢 Група 1 — Index
Сюди потрапляють:
- основні статті;
- послуги;
- товари;
- якісні категорії;
- landing pages;
- сторінки з реальним пошуковим попитом.
🟡 Група 2 — Noindex
Сюди можуть потрапляти:
- внутрішній пошук;
- thank-you;
- службові сторінки;
- слабкі архіви;
- непотрібні taxonomy;
- технічні URL.
🔴 Група 3 — Не noindex, а інше рішення
Наприклад:
- видалити;
- 301 redirect;
- 404;
- 410;
- canonical;
- password protection;
- змінити структуру URL.
Саме третя група часто залишається поза увагою.
🧭 Noindex і XML Sitemap
Якщо URL позначений noindex, логічно не включати його до XML sitemap, якщо sitemap генерується автоматично SEO-плагіном.
XML sitemap має допомагати пошуковій системі знаходити URL, які ви хочете розглядати як важливі для індексації.
Тому потенційно проблемною є ситуація:
XML sitemap → URLодночасно з:
robots meta → noindexЦе не обов'язково означає миттєву SEO-катастрофу, але така конфігурація створює суперечливий сигнал щодо ролі URL.
Для noindex-сторінок варто перевіряти, чи не потрапляють вони до sitemap через налаштування SEO-плагіна або кастомну логіку.
🧠 Чи передає noindex посилальну вагу
Не варто будувати SEO-стратегію навколо припущення:
"Якщо поставити
noindex, вся вага сторінки автоматично перейде на інші сторінки."
Noindex насамперед є директивою щодо індексації.
Якщо вам потрібно змінити роль старої сторінки, часто кращими інструментами будуть:
- 301 redirect;
- canonical;
- оновлення контенту;
- перелінковка;
- об'єднання сторінок.
🧩 Noindex для custom post types
WordPress дозволяє створювати custom post types.
Наприклад:
- portfolio;
- case-study;
- locations;
- events;
- doctors;
- properties;
- courses.
Не можна автоматично застосовувати одне правило до всіх custom post types.
Наприклад:
/case-study/seo-project/може бути важливою SEO-сторінкою.
А технічний post type, який використовується тільки для внутрішнього функціоналу сайту, може потребувати noindex.
Тому кожен custom post type потрібно оцінювати окремо.
🧱 Noindex для кастомних таксономій
Те саме стосується custom taxonomies.
Наприклад, сайт нерухомості може мати:
- місто;
- район;
- тип нерухомості;
- кількість кімнат;
- ціновий діапазон.
Деякі з цих сторінок можуть бути дуже цінними:
/kyiv/apartments/Інші комбінації можуть генерувати тисячі слабких URL.
Тут потрібна не механічна заборона індексації всього, а контрольована faceted navigation strategy.
🧪 Чеклист перед встановленням noindex
Перед тим як закрити URL від індексації, поставте собі 10 запитань:
- Чи має ця сторінка органічний пошуковий попит?
- Чи відповідає вона окремому пошуковому наміру?
- Чи може вона приносити органічний трафік?
- Чи є на ній унікальний корисний контент?
- Чи потрібна вона користувачам?
- Чи є вона частиною навігації?
- Чи дублює вона іншу сторінку?
- Чи краще використати canonical?
- Чи краще зробити 301 redirect?
- Чи справді користувачам потрібен URL, але Google — ні?
Якщо на останнє питання відповідь "так", noindex часто є логічним кандидатом.
🔍 Як знайти сторінки, які помилково отримали noindex
Періодично перевіряйте сайт на предмет сторінок, які випадково закриті від індексації.
Особливу увагу приділіть:
- новим статтям;
- новим товарам;
- категоріям;
- landing pages;
- сторінкам послуг;
- важливим taxonomy;
- custom post types.
Проблема може виникнути після:
- зміни SEO-плагіна;
- зміни теми;
- міграції;
- імпорту контенту;
- масового редагування;
- зміни шаблонів;
- налаштування WooCommerce.
🔄 Що відбувається після видалення noindex
Якщо ви змінили сторінку з:
noindexна:
indexGoogle не обов'язково покаже її в пошуку миттєво.
Пошуковій системі потрібно:
- знову знайти URL;
- просканувати сторінку;
- побачити нову directive;
- обробити зміни;
- за потреби повторно оцінити сторінку.
Тому після критичних змін можна перевірити URL через Google Search Console.
🛠️ WordPress noindex: оптимальна схема роботи
Для більшості сайтів можна використовувати таку послідовність:
Крок 1. Зробіть карту URL
Визначте:
- сторінки;
- записи;
- категорії;
- теги;
- авторів;
- дати;
- custom post types;
- custom taxonomies;
- WooCommerce;
- пошук;
- фільтри.
Крок 2. Розділіть URL за роллю
SEO-контент
→ повинен індексуватися.
Службовий контент
→ потенційно noindex.
Дублікати
→ canonical / redirect / consolidation.
Приватний контент
→ authentication/password protection.
Крок 3. Налаштуйте SEO-плагін
Автоматизуйте очевидні випадки.
Крок 4. Залиште можливість ручного noindex
Для нестандартних сторінок.
Крок 5. Перевірте robots.txt
Переконайтеся, що noindex-сторінки не заблоковані від crawl, якщо вам потрібно, щоб Google прочитав directive.
Крок 6. Перевірте sitemap
Переконайтеся, що індексаційна стратегія та sitemap узгоджені.
Крок 7. Перевірте Search Console
Особливо після великих змін.
🏁 Висновок
Noindex у WordPress — це інструмент керування індексацією, а не універсальна SEO-кнопка.
Його головне завдання — допомогти визначити, які URL можуть бути присутні у пошуковій видачі, а які повинні залишатися доступними користувачам без органічної індексації.
Найчастіше noindex може бути доречним для:
- внутрішнього пошуку;
- thank-you pages;
- службових сторінок;
- checkout;
- cart;
- account;
- слабких архівів;
- порожніх taxonomy;
- частини авторських і датованих архівів;
- окремих технічних URL.
Водночас не варто автоматично ставити noindex на всі категорії, теги, товари, записи або архіви.
Кожна сторінка повинна оцінюватися з точки зору:
- пошукового наміру;
- унікальності;
- корисності;
- органічного потенціалу;
- ролі в інформаційній архітектурі;
- внутрішньої перелінковки;
- дублювання;
- технічного призначення.
І найважливіше:
Якщо сторінка потрібна користувачам, але не має самостійної SEO-цінності —
noindexчасто є правильним рішенням. Якщо сторінка має пошукову цінність — не закривайте її тільки тому, що це категорія, тег, архів або сторінка WordPress.
Правильна стратегія — не максимально зменшити кількість проіндексованих URL, а залишити в пошуковому індексі саме ті сторінки, які мають реальну цінність для пошуку та користувача.
❓ FAQ: поширені запитання про noindex у WordPress
Що таке noindex у WordPress?
Noindex — це robots directive, яка повідомляє пошуковим системам не включати певну сторінку або ресурс до пошукового індексу. Для HTML-сторінок вона зазвичай реалізується через robots meta tag.
Чи впливає noindex на ранжування сторінки?
Так, але не в тому сенсі, що noindex "знижує позиції". Основна функція директиви — не показувати URL у пошуковій видачі. Тому сторінка з noindex не повинна використовуватися як звичайна органічна landing page.
Чим noindex відрізняється від nofollow?
Noindex стосується появи сторінки у пошуковому індексі. Nofollow стосується переходу пошукового робота за посиланнями на сторінці. Це різні directives.
Чи потрібно ставити noindex, nofollow?
Не обов'язково. Якщо потрібно лише виключити сторінку з пошуку, часто достатньо noindex. Google окремо обробляє directives noindex та nofollow.
Чи потрібно закривати категорії WordPress від індексації?
Ні, не всі. Якісна категорія може бути повноцінною SEO-посадковою сторінкою. Noindex варто розглядати для слабких, дубльованих або непотрібних taxonomy pages.
Чи потрібно ставити noindex на теги WordPress?
Не автоматично. Якщо теги створюють корисні тематичні сторінки, їх можна залишити індексованими. Якщо вони генерують слабкі або дубльовані архіви, noindex може бути доцільним.
Чи потрібно ставити noindex на сторінку подяки?
У більшості типових сценаріїв сторінка подяки є службовою і не має самостійної пошукової цінності, тому noindex часто є логічним рішенням.
Чи потрібно ставити noindex на сторінку пошуку WordPress?
Зазвичай так. WordPress має штатний механізм додавання noindex для сторінок внутрішнього пошуку.
Чи можна використовувати robots.txt замість noindex?
Ні, якщо завдання полягає саме у видаленні URL з пошукового індексу. Google прямо зазначає, що robots.txt не є механізмом гарантованого видалення сторінки з Google Search.
Чи можна одночасно використовувати robots.txt і noindex?
Технічно можна, але якщо robots.txt блокує crawl, Google може не побачити noindex на сторінці. Якщо необхідно, щоб Google обробив noindex, URL не слід блокувати від сканування через robots.txt.
Чи можна поставити noindex без SEO-плагіна?
Так. WordPress має wp_robots API, через який розробник може програмно додавати robots directives.
Як поставити noindex на PDF?
Для PDF та інших не-HTML ресурсів використовується HTTP-заголовок X-Robots-Tag, наприклад X-Robots-Tag: noindex.
Чи робить noindex сторінку приватною?
Ні. Noindex не забороняє користувачам відкривати URL. Для приватної або конфіденційної інформації потрібна авторизація, пароль або інший механізм контролю доступу.
Чи потрібно видаляти noindex зі всіх сторінок?
Ні. Частина сторінок WordPress цілком обґрунтовано може залишатися noindex. Важливо не прагнути до максимальної кількості проіндексованих URL, а побудувати логічну структуру індексації.
Чи може noindex нашкодити SEO?
Так, якщо випадково застосувати його до важливих сторінок. Особливо небезпечний глобальний noindex або масове закриття товарів, категорій, статей та комерційних landing pages.
Як перевірити, чи сторінка має noindex?
Перевірте вихідний HTML сторінки та знайдіть robots meta directive. Для додаткової діагностики використовуйте URL Inspection у Google Search Console. Для не-HTML ресурсів перевіряйте HTTP response headers.
Чи потрібно додавати noindex у XML sitemap?
Як правило, sitemap краще використовувати для URL, які ви хочете, щоб пошукові системи знаходили та розглядали для індексації. Тому noindex-URL зазвичай не повинні бути ціллю sitemap.
Що краще: noindex чи 301 redirect?
Це залежить від ситуації. Якщо URL потрібно залишити доступним користувачам, але прибрати з пошуку, noindex може бути доречним. Якщо сторінка замінена іншою релевантною сторінкою, 301 redirect часто вирішує іншу задачу — перенаправлення користувача та пошукової системи на новий URL.
Чи потрібно ставити noindex на архіви авторів?
Не завжди. На багатoавторських сайтах вони можуть бути корисними. На сайтах з одним автором авторський архів часто не має окремої цінності, тому його можна вимкнути або виключити з пошуку.
Чи потрібно ставити noindex на архіви дат?
Це залежить від структури сайту. Якщо date archives лише дублюють інші сторінки та не мають окремої пошукової цінності, їх можна виключити з індексації або вимкнути.
Що робити, якщо важлива сторінка випадково отримала noindex?
Приберіть noindex, перевірте фінальний HTML, sitemap і Search Console. Після повторного crawl пошукова система зможе повторно обробити URL.
Чи є noindex фактором ранжування?
Noindex — це насамперед директива щодо індексації та показу URL у пошуку, а не класичний "фактор ранжування", який підвищує чи знижує позицію сторінки. Його використовують для керування тим, які URL можуть брати участь у пошуку.

