

Привіт:) Robots.txt — невеликий текстовий файл, який повідомляє пошуковим роботам, які URL-адреси або розділи сайту вони можуть або не повинні сканувати. Для WordPress цей файл може бути особливо важливим на великих сайтах, інтернет-магазинах, проєктах із фільтрами, параметрами URL, великою кількістю технічних сторінок та інших ресурсів, де потрібно контролювати роботу краулерів.
Водночас robots.txt часто використовують неправильно. Наприклад, намагаються за його допомогою прибрати сторінки з Google, закривають CSS і JavaScript, блокують цілі каталоги WordPress або додають десятки непотрібних правил.
Правильно налаштований robots.txt має виконувати конкретне завдання: контролювати сканування сайту пошуковими роботами, не заважаючи їм отримувати доступ до важливого контенту та необхідних ресурсів.
Google прямо зазначає, що robots.txt призначений насамперед для керування скануванням, а не для приховування сторінок від пошуку. Якщо потрібно заборонити індексацію сторінки, слід використовувати noindex або інший відповідний механізм.
-
🔎 Що таке
robots.txtі навіщо він потрібен -
⚙️ Як працює
robots.txt -
🆚
Robots.txt,noindexі пароль: у чому різниця -
🗂️ Де знаходиться
robots.txtу WordPress -
🧩 Який
robots.txtстворює WordPress за замовчуванням -
🛠️ Як правильно створити
robots.txtу WordPress -
1. ✏️ Створити фізичний файл
robots.txt -
2. ⚙️ Змінювати
robots.txtчерез WordPress - 3. 🧩 Використовувати SEO-плагін
-
🧱 Основний синтаксис
robots.txt -
🤖
User-agent: для якого робота працює правило -
🚫 Що означає
Disallow -
✅ Що означає
Allow -
🗺️ Як додати Sitemap у
robots.txt -
🔍 Чи потрібно додавати Sitemap у
robots.txt -
🧠 Чи потрібно закривати
/wp-admin/у WordPress -
⚠️ Чи потрібно закривати
wp-includes - 🎨 Чи потрібно блокувати CSS і JavaScript
-
🛒
Robots.txtдля WooCommerce -
🔗
Robots.txtі URL з параметрами - 🧹 Чи потрібно блокувати пошук WordPress
-
🏷️
Robots.txtіnoindex: правильна стратегія -
📋 Рекомендований базовий
robots.txtдля WordPress -
🚨 Чого НЕ потрібно робити в
robots.txt -
❌ 1. Не використовуйте
robots.txtдля видалення сторінок із Google - ❌ 2. Не закривайте весь сайт
- ❌ 3. Не блокуйте CSS і JavaScript без причини
- ❌ 4. Не використовуйте crawl-delay як універсальне рішення
- ❌ 5. Не додавайте сотні правил "про всяк випадок"
- 🧩 Wildcard у robots.txt
- 🔬 Як Google визначає, яке правило застосувати
-
🧪 Як перевірити
robots.txtпісля налаштування - 1. Чи відкривається файл
-
2. Чи немає
Disallow: / - 3. Чи не заблоковані важливі розділи
- 4. Чи правильний Sitemap
- 🧰 Перевірка через Google Search Console
-
📊 Чекліст аудиту
robots.txtWordPress -
🏗️
Robots.txtдля маленького WordPress-сайту -
🏢
Robots.txtдля великого WordPress-сайту -
🛍️
Robots.txtдля інтернет-магазину WordPress - 🟢 Група 1 — сторінки, які повинні скануватися
- 🟡 Група 2 — сторінки, які можуть бути доступні, але не повинні індексуватися
- 🔴 Група 3 — URL, які не потрібно сканувати
- 🔐 Чи можна приховати секретну інформацію через robots.txt
-
🧱 Чи впливає
robots.txtна SEO -
📈
Robots.txtі crawl budget -
🔄 Що робити після зміни
robots.txt -
🚀
Robots.txtпісля міграції WordPress -
🧪 Як знайти помилку в
robots.txt -
Крок 1. Відкрити
robots.txt -
Крок 2. Знайти
Disallow - Крок 3. Перевірити Sitemap
- Крок 4. Перевірити Search Console
- Крок 5. Перевірити URL Inspection
-
🧠 Практична стратегія налаштування
robots.txt - 1️⃣ Перевірте поточний файл
- 2️⃣ Визначте проблему
-
3️⃣ Перевірте, чи справді потрібен
robots.txt - 4️⃣ Додайте мінімально необхідні правила
- 5️⃣ Додайте Sitemap
- 6️⃣ Перевірте важливі URL
- 7️⃣ Перевірте Search Console
-
📝 Готовий чекліст перед публікацією
robots.txt -
❓ FAQ: часті запитання про
robots.txtу WordPress -
❓ Що таке
robots.txtу WordPress? -
❓ Чи потрібен
robots.txtкожному WordPress-сайту? -
❓ Де знаходиться
robots.txtу WordPress? -
❓ Чи можна створити
robots.txtчерез WordPress? -
❓ Чи потрібно додавати Sitemap у
robots.txt? -
❓ Чи можна через
robots.txtзаборонити індексацію сторінки? -
❓ Чи можна використовувати
noindexуrobots.txt? -
❓ Чи потрібно закривати
wp-admin? -
❓ Чи потрібно закривати
wp-includes? - ❓ Чи потрібно блокувати CSS і JavaScript?
-
❓ Чи захищає
robots.txtконфіденційні файли? -
❓ Чи впливає
robots.txtна позиції сайту в Google? -
❓ Що означає
User-agent: *? -
❓ Що означає
Disallow: /? -
❓ Що означає
Disallow: /wp-admin/? -
❓ Чи можна додати кілька Sitemap у
robots.txt? - ❓ Чи підтримує Google crawl-delay?
-
❓ Чи потрібно змінювати
robots.txtпісля кожного оновлення WordPress? - 🎯 Висновок
У цьому матеріалі розберу, що таке robots.txt у WordPress, де він знаходиться, як його правильно створити та налаштувати, які правила використовувати, чого не варто блокувати, як додати Sitemap і як перевірити файл після внесення змін.
🔎 Що таке robots.txt і навіщо він потрібен
robots.txt — це текстовий файл, розташований у корені сайту за адресою:
https://example.com/robots.txtЙого читають пошукові роботи та інші краулери перед скануванням ресурсів сайту.
Файл містить правила, які визначають, для яких роботів вони застосовуються та які шляхи дозволено або заборонено сканувати.
Google визначає robots.txt як механізм, за допомогою якого власник сайту може вказати краулерам, які URL вони можуть або не можуть запитувати.
Наприклад, правило:
Disallow: /private/повідомляє роботу, що URL-адреси всередині /private/ не слід сканувати.
Однак це не є механізмом захисту інформації.
Якщо інформація є конфіденційною, її не можна захищати лише за допомогою robots.txt. Для цього потрібні авторизація, пароль або інший механізм контролю доступу.
⚙️ Як працює robots.txt
Принцип роботи досить простий:
Пошуковий робот → відкриває robots.txt → визначає правила для свого User-agent → перевіряє URL → приймає рішення про скануванняВажливо розуміти, що robots.txt не є командою, яка змушує Google видалити сторінку з індексу.
Наприклад, якщо сторінка:
https://example.com/test-page/закрита правилом:
Disallow: /test-page/Googlebot не повинен отримувати цю сторінку для сканування.
Але URL все одно потенційно може з'явитися в результатах пошуку, якщо Google дізнається про нього з інших джерел. Google прямо попереджає, що блокування через robots.txt не гарантує виключення URL із пошукової видачі.
🆚 Robots.txt, noindex і пароль: у чому різниця
Це одна з найважливіших тем у технічному SEO.
| Завдання | Рекомендований механізм |
|---|---|
| Заборонити краулеру сканувати певний URL | robots.txt |
| Заборонити індексацію HTML-сторінки | noindex |
| Заборонити індексацію PDF або іншого не-HTML ресурсу | X-Robots-Tag |
| Повністю приховати приватний контент | Авторизація / пароль |
| Повідомити Google про важливі URL | XML Sitemap |
| Керувати канонічною версією | rel="canonical" |
Особливо важливо: не потрібно блокувати сторінку через robots.txt, якщо ви хочете, щоб Google прочитав на ній noindex.
Google не зможе побачити noindex, якщо робот не має доступу до сторінки.
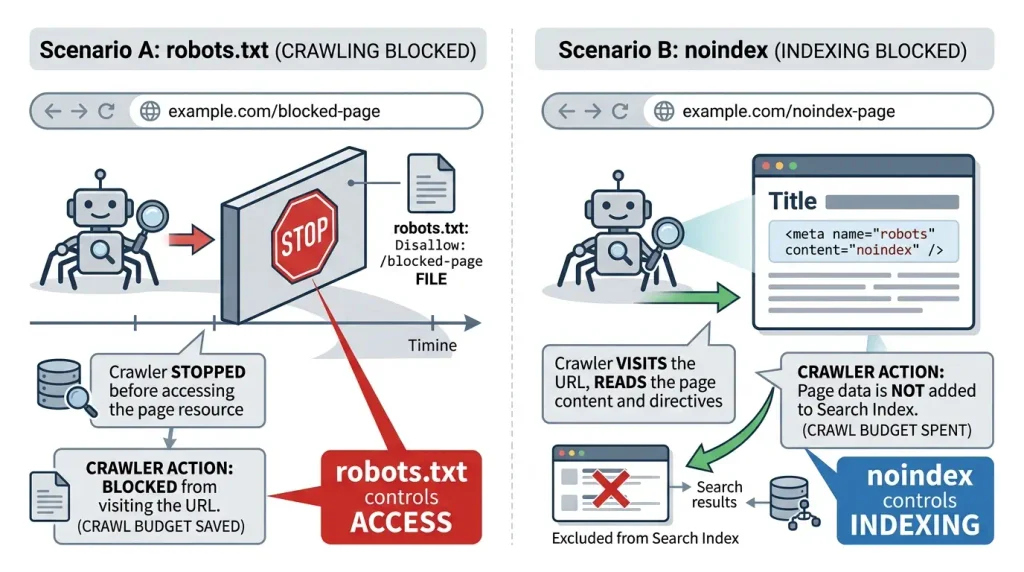
Просте правило
Robots.txt відповідає на питання:
"Чи можна роботу заходити сюди?"
Noindex відповідає на питання:
"Чи потрібно включати цю сторінку до пошукового індексу?"
Це різні завдання.
🗂️ Де знаходиться robots.txt у WordPress
Перше, що потрібно зробити, — перевірити:
https://ваш-домен.com/robots.txtНаприклад:
https://example.com/robots.txtУ сучасному WordPress robots.txt може генеруватися динамічно самим WordPress. У ядрі WordPress передбачена функція do_robots(), яка формує стандартний вміст файлу та дозволяє змінювати його через фільтр robots_txt.
Тому відсутність фізичного файлу robots.txt у файловій системі не обов'язково означає, що сайт не має robots.txt.
Це важливий момент для WordPress.
🧩 Який robots.txt створює WordPress за замовчуванням
Стандартна логіка WordPress передбачає базове правило для адміністративного каталогу та окремий дозвіл для admin-ajax.php.
Типова структура може виглядати приблизно так:
User-agent: *Disallow: /wp-admin/Allow: /wp-admin/admin-ajax.phpТочний результат залежить від конфігурації сайту та встановлених компонентів.
У більшості випадків не потрібно автоматично замінювати стандартний robots.txt величезним набором правил.
Спочатку потрібно визначити, чи існує реальна SEO-проблема, яку необхідно вирішити.
🛠️ Як правильно створити robots.txt у WordPress
Є кілька способів.
1. ✏️ Створити фізичний файл robots.txt
Можна створити файл із назвою:
robots.txtі розмістити його в кореневому каталозі сайту.
У такому випадку він має бути доступний за:
https://example.com/robots.txtЦей варіант підходить для сайтів, де адміністратор має доступ до файлової системи або сервера.
2. ⚙️ Змінювати robots.txt через WordPress
WordPress передбачає фільтр robots_txt, який дозволяє змінювати вміст динамічно.
Це може бути корисно розробникам, які хочуть централізовано формувати правила.
Наприклад, через код можна додати певний Disallow або Sitemap.
Однак для звичайного сайту не варто редагувати ядро WordPress.
3. 🧩 Використовувати SEO-плагін
Деякі SEO-плагіни дозволяють керувати robots.txt через адміністративну панель.
Перевага цього способу — менша ймовірність помилки під час роботи з файловою системою.
Недолік — залежність від конкретного плагіна та його реалізації.
Тому після будь-яких змін все одно потрібно відкрити:
/robots.txtі перевірити фактичний результат.
🧱 Основний синтаксис robots.txt
Robots.txt має простий текстовий синтаксис.
Основні директиви:
| Директива | Призначення |
|---|---|
User-agent | Визначає, до якого робота належать правила |
Disallow | Забороняє сканування певного шляху |
Allow | Дозволяє сканування певного шляху |
Sitemap | Повідомляє адресу XML Sitemap |
# | Додає коментар |
Google підтримує саме ці основні поля в robots.txt; наприклад, crawl-delay Google не підтримує.
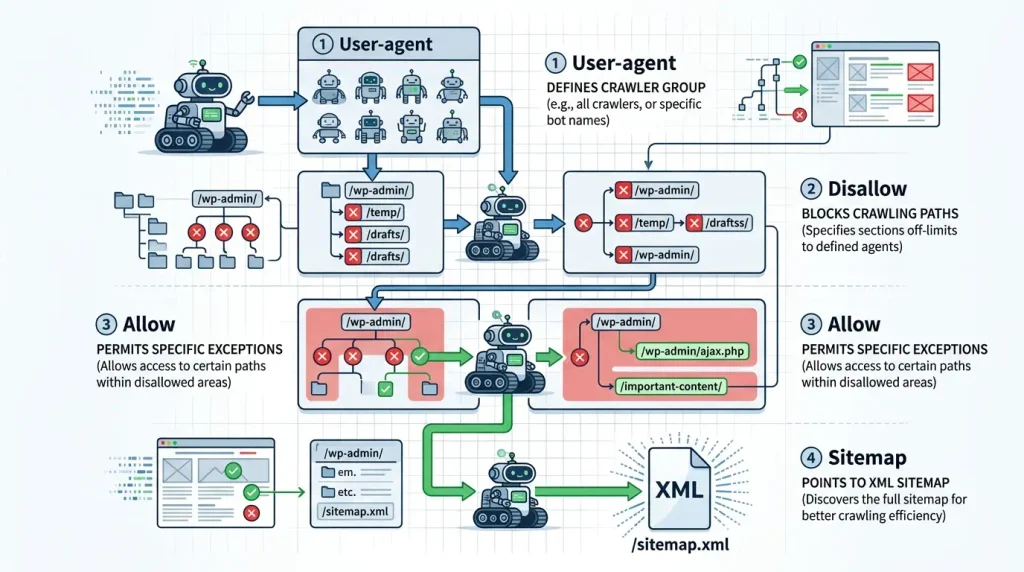
🤖 User-agent: для якого робота працює правило
Наприклад:
User-agent: *означає, що наступні правила застосовуються до всіх роботів, які підпадають під цю групу.
Зірочка * — універсальний варіант.
Можна створювати окремі групи для конкретних роботів.
Наприклад, окремі правила можуть адресуватися Googlebot.
Але без конкретної необхідності не варто створювати складну систему правил для десятків роботів.
Чим простіша конфігурація, тим легше її підтримувати та перевіряти.
🚫 Що означає Disallow
Disallow забороняє краулеру сканувати зазначений шлях.
Наприклад:
Disallow: /private/означає, що для відповідної групи роботів шлях /private/ закритий для сканування.
Правило:
Disallow: /є значно радикальнішим — воно фактично забороняє сканування всього сайту для відповідної групи.
Тому таке правило на комерційному або контентному сайті може мати серйозні наслідки.
✅ Що означає Allow
Allow дозволяє сканування шляху, навіть якщо ширше правило його забороняє.
Наприклад, Google описує ситуації, де більш специфічне правило Allow має перевагу над ширшим Disallow. Для конфліктних правил Google враховує специфічність шляху.
Це дозволяє створювати конструкції на кшталт:
Disallow: /folder/і окремо дозволяти:
Allow: /folder/important-page/Але використовувати такі конструкції потрібно обережно.
Якщо конфігурацію можна зробити простішою без Allow, краще зробити її простішою.
🗺️ Як додати Sitemap у robots.txt
Одна з найкорисніших директив — Sitemap.
Наприклад:
Sitemap: https://example.com/sitemap.xmlSitemap має містити повну URL-адресу, включно з протоколом і доменом.
Google підтримує Sitemap у robots.txt, причому можна вказати кілька Sitemap.
Для WordPress конкретний URL Sitemap залежить від того, який механізм генерації використовується на сайті.
Тому не варто копіювати адресу з чужого сайту.
Спочатку відкрийте власну Sitemap і переконайтеся, що вона існує.
🔍 Чи потрібно додавати Sitemap у robots.txt
Це не є абсолютною вимогою.
Google може знаходити Sitemap через Google Search Console або інші механізми.
Однак зазначення Sitemap у robots.txt є зручним способом повідомити пошуковим роботам про її розташування.
XML Sitemap допомагає пошуковим системам ефективніше знаходити важливі URL, особливо на великих або складних сайтах. Google зазначає, що Sitemap є особливо корисною для великих сайтів, нових сайтів із невеликою кількістю зовнішніх посилань та сайтів із великою кількістю мультимедійного контенту.
🧠 Чи потрібно закривати /wp-admin/ у WordPress
У стандартному WordPress цей каталог уже врахований базовою логікою robots.txt.
Тому немає необхідності дублювати одне й те саме правило багато разів.
Важливо також розуміти, що:
/wp-admin/не є звичайною SEO-сторінкою.
Його закриття від пошукових роботів не є способом захисту адміністративної панелі.
Безпека WordPress повинна забезпечуватися:
- надійними паролями;
- двофакторною автентифікацією;
- актуальною версією WordPress;
- оновленням плагінів і тем;
- правильними правами доступу;
- захистом сервера;
- обмеженням доступу до адміністративної частини за потреби.
⚠️ Чи потрібно закривати wp-includes
Це одна з найпоширеніших SEO-помилок у WordPress.
Автоматично додавати:
Disallow: /wp-includes/лише тому, що це технічна директорія WordPress, не варто.
Пошуковим системам можуть бути потрібні ресурси, що використовуються для нормального відображення та аналізу сторінок.
Google окремо рекомендує не блокувати необхідні ресурси, якщо їх недоступність заважає коректно обробляти сторінку.
Тому правило:
"Усе, що починається з
wp-, потрібно закрити"
є неправильним підходом.
🎨 Чи потрібно блокувати CSS і JavaScript
У більшості сучасних WordPress-сайтів — ні.
Пошукові системи повинні мати можливість отримувати ресурси, необхідні для коректного розуміння та рендерингу сторінки.
Тому не варто додавати масові правила на кшталт:
- блокування всього
/wp-content/; - блокування
/wp-includes/; - блокування
.css; - блокування
.js; - блокування всіх зображень.
Такі правила можуть створити проблеми з тим, як пошукова система бачить сторінку.
Google рекомендує перевіряти доступність важливих ресурсів через URL Inspection та не блокувати ресурси, які потрібні для правильного відображення сторінки.
🛒 Robots.txt для WooCommerce
Для інтернет-магазинів robots.txt потребує особливої уваги.
WooCommerce може створювати:
- кошик;
- checkout;
- сторінку облікового запису;
- параметри сортування;
- фільтри;
- варіації URL;
- технічні параметри;
- інші URL, які не мають самостійної SEO-цінності.
Але не потрібно бездумно блокувати всі ці URL через robots.txt.
Спочатку визначте, чи проблема полягає у скануванні, чи в індексації.
Якщо сторінку потрібно залишити доступною для Googlebot, але не включати до індексу, часто правильнішим рішенням буде noindex, а не Disallow.
Google рекомендує використовувати robots.txt для керування непотрібним скануванням, а page-level noindex — коли завдання полягає саме в контролі індексації.
🔗 Robots.txt і URL з параметрами
Наприклад:
/catalog/?color=red
/catalog/?sort=price
/catalog/?filter=brand
можуть створювати величезну кількість URL.
На великих сайтах це здатне збільшувати кількість URL, які потрібно обробляти пошуковому роботу.
Google окремо розглядає керування faceted navigation і зазначає, що robots.txt може використовуватися для контролю непотрібного сканування таких URL.
Але універсального правила для всіх магазинів немає.
Перед блокуванням потрібно перевірити:
- чи створює URL унікальний контент;
- чи може він приносити органічний трафік;
- чи має він зовнішні посилання;
- чи є він канонічним;
- чи є такі URL масовими;
- чи створюють вони реальне навантаження на сервер;
- чи потрібно контролювати їх індексацію або саме сканування.
🧹 Чи потрібно блокувати пошук WordPress
Внутрішній пошук WordPress часто створює URL на кшталт:
/?s=ключове-словоТакі сторінки зазвичай не є основними SEO-сторінками сайту.
При цьому WordPress має вбудовану логіку noindex для сторінок внутрішнього пошуку. У ядрі WordPress функція wp_robots_noindex_search() додає noindex, коли виконується пошук.
Це хороший приклад того, чому не потрібно автоматично намагатися вирішувати всі SEO-завдання через robots.txt.
🏷️ Robots.txt і noindex: правильна стратегія
Розглянемо типовий сценарій.
Ви маєте URL:
https://example.com/search/?q=wordpressі хочете, щоб він не з'являвся в Google.
Неправильний підхід:
Disallow: /search/якщо при цьому ви очікуєте, що Google прочитає noindex.
Правильна логіка:
Googlebot має отримати доступ → побачити noindex → не індексувати сторінкуСаме тому Google наголошує, що URL із noindex не повинен бути заблокований robots.txt.
📋 Рекомендований базовий robots.txt для WordPress
Для багатьох стандартних WordPress-сайтів не потрібно створювати складний robots.txt.
Концептуально він може містити:
- універсальну групу
User-agent: *; - мінімальну кількість необхідних
Disallow; Allow, якщо він реально потрібен;- адресу XML Sitemap.
Наприклад, логіка може виглядати так:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/sitemap.xml
Але це шаблон для розуміння структури, а не універсальний файл, який потрібно механічно вставити на кожен сайт.
У WordPress частина цих правил може вже генеруватися ядром.
🚨 Чого НЕ потрібно робити в robots.txt
Ось список найбільш небезпечних типових помилок.
❌ 1. Не використовуйте robots.txt для видалення сторінок із Google
Disallow не дорівнює noindex.
URL може залишатися відомим пошуковій системі навіть без доступу до його вмісту.
❌ 2. Не закривайте весь сайт
Найнебезпечніше правило:
Disallow: /для User-agent: *.
На робочому сайті воно може фактично заборонити пошуковим роботам сканувати весь ресурс.
❌ 3. Не блокуйте CSS і JavaScript без причини
Це може погіршити можливість пошукової системи коректно обробляти сторінки.
❌ 4. Не використовуйте crawl-delay як універсальне рішення
Google не підтримує crawl-delay як поле robots.txt.
Якщо сервер перевантажується через краулерів, проблема потребує технічного аналізу, а не просто додавання непідтримуваної директиви.
❌ 5. Не додавайте сотні правил "про всяк випадок"
Великий robots.txt не означає професійний robots.txt.
Навпаки, чим більше правил, тим вища ймовірність:
- конфліктів;
- випадкового блокування важливих URL;
- складності підтримки;
- помилок після зміни структури сайту.
Google має обмеження розміру robots.txt у 500 кілобайт; вміст після цього ліміту ігнорується.
Для звичайного WordPress-сайту це дуже великий запас, але він добре демонструє принцип: robots.txt не повинен перетворюватися на величезну базу винятків.
🧩 Wildcard у robots.txt
Google підтримує wildcard * у шляхах.
Наприклад:
Disallow: /*?може використовуватися для роботи з URL, які містять параметри.
Також підтримується $, який дозволяє позначити кінець URL-шляху.
Наприклад, правило для конкретного розширення може мати відповідну конструкцію з $.
Однак wildcard-правила потрібно тестувати особливо уважно.
Одне коротке правило може охопити значно більше URL, ніж передбачалося.
Google описує правила зі wildcard та алгоритм визначення найбільш специфічного збігу у своїй специфікації robots.txt.
🔬 Як Google визначає, яке правило застосувати
При конфлікті правил Google використовує найбільш специфічне правило за довжиною шляху.
Наприклад, умовно:
Disallow: /і:
Allow: /important/не означають, що /important/ автоматично залишається заблокованим.
Більш специфічне правило може дозволити доступ до /important/.
Google також зазначає, що при конфлікті правил із однаковою специфічністю застосовується менш обмежувальне правило.
Саме тому складні конструкції з великою кількістю Allow та Disallow потрібно тестувати, а не оцінювати "на око".
🧪 Як перевірити robots.txt після налаштування
Після будь-яких змін обов'язково відкрийте:
https://example.com/robots.txtі перевірте:
1. Чи відкривається файл
Він повинен повертати коректний текстовий документ.
2. Чи немає Disallow: /
Якщо ви не планували повністю блокувати сайт, такого правила для User-agent: * бути не повинно.
3. Чи не заблоковані важливі розділи
Перевірте:
- головну;
- статті;
- категорії;
- товари;
- сторінки послуг;
- важливі медіаресурси;
- CSS;
- JavaScript.
4. Чи правильний Sitemap
Переконайтеся, що URL Sitemap:
- існує;
- доступний;
- містить потрібні URL;
- використовує правильний домен;
- відповідає протоколу сайту.
🧰 Перевірка через Google Search Console
Google Search Console — один із ключових інструментів для технічного SEO.
Після зміни robots.txt варто перевіряти важливі URL за допомогою URL Inspection.
Google рекомендує використовувати URL Inspection, щоб перевірити, як Google бачить сторінку, зокрема чи не заважають її скануванню robots.txt, noindex або авторизація.
Перевіряйте не лише головну сторінку.
Особливо корисно протестувати:
- одну статтю;
- одну категорію;
- одну сторінку;
- один товар;
- URL із параметрами;
- важливий медіаресурс.
📊 Чекліст аудиту robots.txt WordPress
| Перевірка | Результат |
|---|---|
/robots.txt відкривається | ✅ |
Немає випадкового Disallow: / | ✅ |
| Головна сторінка доступна | ✅ |
| Важливі статті доступні | ✅ |
| Категорії не заблоковані випадково | ✅ |
| Товари не заблоковані випадково | ✅ |
| CSS/JS не блокуються без причини | ✅ |
| Sitemap вказана коректно | ✅ |
| Sitemap реально існує | ✅ |
| Немає зайвих дубльованих правил | ✅ |
noindex не плутають із Disallow | ✅ |
| Після змін перевірено Search Console | ✅ |
🏗️ Robots.txt для маленького WordPress-сайту
Якщо у вас невеликий корпоративний сайт на 20–100 сторінок, зазвичай немає потреби створювати складну систему блокування.
Для такого сайту набагато важливіше:
- правильна структура URL;
- якісна внутрішня перелінковка;
- коректний Sitemap;
- відсутність випадкового
noindex; - правильні canonical;
- швидке завантаження;
- якісний контент.
Google зазначає, що для невеликих сайтів із добре пов'язаними сторінками Sitemap може бути менш критичним, оскільки Google здатен знаходити сторінки через внутрішні посилання. Водночас Sitemap залишається корисним інструментом.
🏢 Robots.txt для великого WordPress-сайту
На великих сайтах ситуація інша.
Наприклад:
- 100 000+ URL;
- WooCommerce;
- тисячі фільтрів;
- faceted navigation;
- багато параметрів;
- кілька типів контенту;
- велика кількість технічних URL.
Тут robots.txt може стати важливим інструментом керування скануванням.
Google рекомендує використовувати robots.txt для URL, які не потрібно сканувати взагалі, особливо коли йдеться про дублікати, нескінченні варіанти URL або інший непотрібний краулінг.
Але навіть на великому сайті не слід блокувати URL лише через те, що вони "виглядають технічними".
Спочатку необхідно зрозуміти, як вони використовуються пошуковою системою.
🛍️ Robots.txt для інтернет-магазину WordPress
Для WooCommerce рекомендується розділити URL на кілька груп.
🟢 Група 1 — сторінки, які повинні скануватися
Наприклад:
- товари;
- категорії;
- важливі інформаційні сторінки;
- корисні посадкові сторінки.
🟡 Група 2 — сторінки, які можуть бути доступні, але не повинні індексуватися
Наприклад, деякі:
- службові сторінки;
- внутрішні результати пошуку;
- технічні варіанти сторінок.
Для них може використовуватися noindex.
🔴 Група 3 — URL, які не потрібно сканувати
Наприклад, певні масові параметризовані варіанти, якщо після аналізу встановлено, що вони не мають SEO-цінності та створюють непотрібне навантаження.
Саме для цієї третьої групи robots.txt може бути особливо корисним.
🔐 Чи можна приховати секретну інформацію через robots.txt
Ні.
Це принципово важливо.
Не можна робити так:
Disallow: /secret/і вважати, що каталог став недоступним.
Robots.txt — це публічний файл.
Будь-який користувач може відкрити:
example.com/robots.txtі побачити правила.
Для конфіденційної інформації потрібно використовувати:
- HTTP authentication;
- пароль;
- систему авторизації;
- серверні правила доступу;
- видалення ресурсу з публічного доступу.
Google прямо рекомендує парольний захист для приватного контенту.
🧱 Чи впливає robots.txt на SEO
Так, але не так, як часто вважають.
Сам файл robots.txt не є магічним SEO-фактором, який підвищує позиції сторінок.
Його роль — допомагати контролювати доступ краулерів до ресурсів.
Правильно налаштований robots.txt може:
- зменшити непотрібне сканування;
- допомогти сфокусувати краулерів на важливих URL;
- зменшити кількість непотрібних запитів;
- запобігати скануванню окремих масових технічних URL.
Неправильно налаштований файл може, навпаки:
- блокувати важливі сторінки;
- блокувати ресурси;
- ускладнювати обробку сайту;
- створювати проблеми зі скануванням.
Тому оптимальний robots.txt — це не той, де найбільше правил.
Оптимальний robots.txt — той, який вирішує конкретні технічні завдання з мінімально необхідною кількістю правил.
📈 Robots.txt і crawl budget
Термін crawl budget часто використовують у контексті великих сайтів.
У спрощеному вигляді йдеться про те, скільки ресурсів пошуковий робот витрачає на сканування сайту.
Якщо сайт має десятки або сотні тисяч непотрібних URL, контроль сканування може бути важливим.
Google рекомендує використовувати robots.txt для сторінок або ресурсів, які ви не хочете, щоб Google сканував узагалі. При цьому Google застерігає від постійної зміни robots.txt лише з метою тимчасового перерозподілу crawl budget.
Тобто:
не потрібно щотижня змінювати robots.txt, намагаючись "підштовхнути" Google до потрібних сторінок.
🔄 Що робити після зміни robots.txt
Після внесення змін рекомендується пройти короткий цикл перевірки:
Зміна → Перевірка файлу → Тест важливих URL → Search Console → МоніторингОсобливо важливо перевіряти сайт після:
- зміни SEO-плагіна;
- зміни теми;
- перенесення сайту;
- зміни CMS;
- переходу на інший хостинг;
- зміни структури URL;
- запуску WooCommerce;
- масштабної зміни фільтрів;
- міграції домену;
- зміни Sitemap.
🚀 Robots.txt після міграції WordPress
Після перенесення сайту з одного домену або сервера перевірте robots.txt одним із перших.
Типова проблема:
старий тестовий сайт мав:
Disallow: /а після запуску продакшн-сайту правило випадково залишилося.
Результат — пошукові роботи не можуть нормально сканувати сайт.
Тому після запуску нового сайту потрібно перевірити:
https://domain.com/robots.txt;- HTTP status;
- Sitemap;
- Search Console;
- URL Inspection;
- основні посадкові сторінки.
🧪 Як знайти помилку в robots.txt
Якщо після зміни robots.txt органічний трафік або індексація почали падати, перевіряйте проблему послідовно.
Крок 1. Відкрити robots.txt
Перевірте фактичний файл, а не той, який ви очікуєте побачити.
Крок 2. Знайти Disallow
Особливу увагу приділіть:
/;/blog/;/category/;/product/;/wp-content/;- wildcard;
- параметрам URL.
Крок 3. Перевірити Sitemap
Переконайтеся, що важливі сторінки присутні.
Крок 4. Перевірити Search Console
Подивіться, чи Google повідомляє про проблеми зі скануванням.
Крок 5. Перевірити URL Inspection
Візьміть конкретну URL-адресу, яка повинна бути доступною.
Це набагато ефективніше, ніж намагатися оцінити robots.txt лише візуально.
🧠 Практична стратегія налаштування robots.txt
Якщо потрібно налаштувати robots.txt на реальному WordPress-сайті, рекомендований порядок дій виглядає так:
1️⃣ Перевірте поточний файл
Відкрийте:
https://ваш-домен.com/robots.txt2️⃣ Визначте проблему
Не починайте з написання правил.
Спочатку визначте:
Які саме URL не потрібно сканувати і чому?
3️⃣ Перевірте, чи справді потрібен robots.txt
Можливо, вам потрібен:
noindex;canonical;- видалення URL;
- авторизація;
- правильна внутрішня перелінковка;
- Sitemap.
4️⃣ Додайте мінімально необхідні правила
Чим простіша конфігурація, тим легше її контролювати.
5️⃣ Додайте Sitemap
Якщо це відповідає структурі сайту.
6️⃣ Перевірте важливі URL
Не обмежуйтеся перевіркою самого тексту robots.txt.
7️⃣ Перевірте Search Console
Особливо після великих змін.
📝 Готовий чекліст перед публікацією robots.txt
Перед тим як вважати налаштування завершеним, перевірте:
- файл доступний за
/robots.txt; - файл повертає коректну відповідь;
User-agentналаштований логічно;- немає випадкового
Disallow: /; - важливі сторінки доступні;
- важливі категорії доступні;
- товари доступні;
- статті доступні;
- необхідні CSS та JavaScript не заблоковані;
- Sitemap має правильний URL;
- Sitemap доступна;
robots.txtне використовується замістьnoindex;- приватний контент захищений не
robots.txt, а системою доступу; - wildcard-правила перевірені;
- після змін перевірено Google Search Console.
❓ FAQ: часті запитання про robots.txt у WordPress
❓ Що таке robots.txt у WordPress?
Robots.txt — текстовий файл у корені сайту, який містить правила для пошукових роботів щодо доступу до URL. WordPress може генерувати robots.txt динамічно через власний механізм.
❓ Чи потрібен robots.txt кожному WordPress-сайту?
Практично кожен публічний сайт має бути доступним за адресою /robots.txt, але це не означає, що потрібно створювати складну систему правил. На невеликому сайті стандартної конфігурації WordPress часто достатньо.
❓ Де знаходиться robots.txt у WordPress?
Він доступний за адресою:
https://ваш-домен.com/robots.txt
Файл може бути фізичним або генеруватися WordPress динамічно.
❓ Чи можна створити robots.txt через WordPress?
Так. Robots.txt може генеруватися самим WordPress, змінюватися через фільтр robots_txt або редагуватися за допомогою відповідних інструментів і SEO-плагінів.
❓ Чи потрібно додавати Sitemap у robots.txt?
Це корисна практика. Google підтримує поле Sitemap, де можна вказати повну адресу XML Sitemap.
❓ Чи можна через robots.txt заборонити індексацію сторінки?
Не варто використовувати robots.txt для цього завдання. Disallow контролює сканування, але не гарантує видалення URL з індексу. Для заборони індексації використовуйте noindex, якщо ресурс доступний для сканування.
❓ Чи можна використовувати noindex у robots.txt?
Google не підтримує noindex як директиву robots.txt. Для сторінок використовується robots meta tag або HTTP-заголовок X-Robots-Tag.
❓ Чи потрібно закривати wp-admin?
WordPress уже передбачає базове правило для /wp-admin/ у стандартному robots.txt.
❓ Чи потрібно закривати wp-includes?
Не слід робити це автоматично. Спочатку потрібно переконатися, що ресурси, які використовуються для роботи та відображення сайту, не будуть випадково заблоковані.
❓ Чи потрібно блокувати CSS і JavaScript?
У більшості випадків — ні. Якщо ресурси потрібні для нормальної обробки сторінки, їх блокування може завадити пошуковій системі правильно її зрозуміти.
❓ Чи захищає robots.txt конфіденційні файли?
Ні. Robots.txt не є системою безпеки. Конфіденційні ресурси необхідно захищати авторизацією, паролем або серверними механізмами доступу.
❓ Чи впливає robots.txt на позиції сайту в Google?
Robots.txt не є інструментом прямого підвищення позицій. Його призначення — керувати доступом краулерів до URL. Неправильне блокування, навпаки, може завадити Google сканувати важливий контент.
❓ Що означає User-agent: *?
Це група правил, яка застосовується до всіх роботів, для яких підходить універсальний user-agent token.
❓ Що означає Disallow: /?
Це правило забороняє сканування всіх шляхів для відповідної групи роботів. На робочому публічному сайті його потрібно використовувати лише тоді, коли повне блокування справді є навмисним.
❓ Що означає Disallow: /wp-admin/?
Воно повідомляє відповідному краулеру не сканувати URL у каталозі /wp-admin/.
❓ Чи можна додати кілька Sitemap у robots.txt?
Так. Google підтримує кілька полів Sitemap у robots.txt.
❓ Чи підтримує Google crawl-delay?
Google не підтримує crawl-delay як поле robots.txt.
❓ Чи потрібно змінювати robots.txt після кожного оновлення WordPress?
Ні. Не потрібно змінювати файл без конкретної причини. Після оновлення варто перевірити його лише тоді, коли змінилися функції, структура сайту або пов'язані SEO-налаштування.
🎯 Висновок
Правильне налаштування robots.txt у WordPress — це не створення максимально великого списку заборон.
Основний принцип значно простіший:
Дозвольте пошуковим роботам сканувати все, що потрібно для нормального розуміння сайту, і блокуйте лише те, що дійсно не потрібно сканувати.
Запам'ятайте чотири ключові правила:
Robots.txtкерує скануванням, а не є основним інструментом деіндексації.- Для
noindexGooglebot повинен мати можливість отримати сторінку. - Не блокуйте CSS, JavaScript та інші необхідні ресурси без конкретної причини.
- Чим простіший
robots.txt, тим легше його контролювати та підтримувати.
Для невеликого WordPress-сайту часто достатньо стандартної конфігурації та коректної Sitemap. Для великих сайтів, WooCommerce, каталогів із фільтрами та проєктів із сотнями тисяч URL robots.txt може стати важливим інструментом керування краулінгом.
Головне — не копіювати чужий robots.txt, а формувати правила на основі реальної структури конкретного сайту, його URL, пошукової індексації та завдань технічного SEO.
Оскільки WordPress і пошукові системи продовжують розвиватися, найнадійніша evergreen-стратегія — регулярно перевіряти актуальну документацію WordPress і Google та тестувати фактичну поведінку сайту після значних технічних змін.

